Pomyśl o danych w swojej firmie: codziennie spływają one z różnych systemów sprzedaży, marketingu i logistyki. Zamiast porządku masz jednak informacyjny chaos, który utrudnia szybkie podejmowanie decyzji i blokuje wdrażanie nowych technologii. Tutaj wchodzi proces ETL – to on zbiera i układa te rozproszone informacje w jednym, centralnym miejscu. Dzięki temu zyskujesz fundament, który pozwala wyprzedzić konkurencję.
Dlaczego musisz wiedzieć, czym jest ETL w dzisiejszym biznesie?
Prawidłowy przepływ informacji to podstawa zarządzania firmą. Bez niego Twoje systemy analityczne i aplikacje po prostu nie będą działać dobrze. Kiedy poznasz mechanizmy integracji danych, łatwiej zaprojektujesz sprawną architekturę IT we własnej organizacji. W ten sposób błyskawicznie przyspieszysz codzienne raportowanie, a przy okazji unikniesz kosztownych błędów analitycznych.
Czym jest ETL i z jakich trzech etapów się składa?
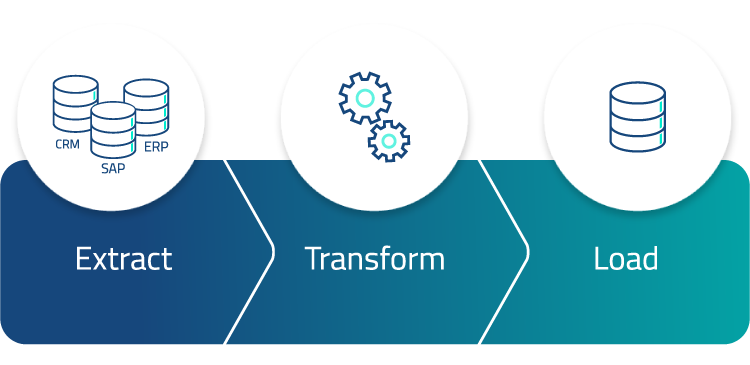
Cały proces opiera się na trzech krokach wykonywanych jeden po drugim: wyodrębnianiu, przekształcaniu i ładowaniu danych. Każdy z nich decyduje o tym, czy Twoje raporty Business Intelligence będą dokładne. Razem tworzą one stabilny, automatyczny rurociąg, który łączy dotychczas niepasujące do siebie systemy. Zobacz, jak wyglądają poszczególne części tego procesu:
Jak krok Extract pozwala pobrać Twoje dane?
Na tym etapie system wyciąga surowe informacje z Twoich baz, systemów ERP, CRM czy zewnętrznych API. Odpowiednie oprogramowanie łączy się ze źródłami, aby bezpiecznie odczytać potrzebne pliki, tabele czy logi zdarzeń. Mogą to być zarówno uporządkowane bazy, jak i pliki CSV, zwykłe arkusze kalkulacyjne czy posty z mediów społecznościowych. Ten krok musi działać szybko i sprawnie, żeby nie obciążać systemów produkcyjnych, z których Twoi pracownicy korzystają na co dzień.
Jak krok Transform wpływa na jakość informacji?
Teraz czas na czyszczenie i ujednolicanie zebranych danych według Twoich zasad biznesowych. Podczas tego kroku inżynierowie danych usuwają duplikaty, uzupełniają braki i poprawiają błędy w formatowaniu. System dodatkowo filtruje i łączy informacje, dzięki czemu zajmują one mniej miejsca przed zapisem. Ten etap decyduje o tym, czy Twoi analitycy dostaną wiarygodne i bezpieczne raporty.
Jak krok Load pozwala zapisać dane w hurtowni?
Na koniec system zapisuje gotowe pakiety informacji w docelowej bazie – najczęściej w hurtowni danych. Tam Twoi pracownicy mają już do nich stały dostęp. Możesz zaplanować ten proces tak, aby system przesyłał dane partiami o określonych godzinach lub robił to bez przerwy, niemal w czasie rzeczywistym. Dobrze zaprogramowany zapis sprawi, że nawet najbardziej skomplikowane zapytania analityczne zadziałają błyskawicznie bez przeciążania serwerów.
Jak automatyzacja procesów biznesowych wykorzystuje procesy ETL?
Jeśli chcesz zautomatyzować procesy w firmie, potrzebujesz stałego dostępu do pewnych i aktualnych informacji. Automatyczne potoki danych uwolnią Twoich pracowników od ręcznego pobierania, zmieniania formatów i przesyłania raportów. Integracja sprawi, że systemy księgowe, platformy marketingowe i interaktywne pulpity menedżerskie same pobiorą świeże dane bez udziału człowieka. Zyskasz dzięki temu płynność działania i zapomnisz o opóźnieniach w komunikacji między działami.
Automatyzacja oparta na integracji danych przyniesie Twojej firmie konkretne korzyści:
- pożegnanie z ręczną pracą – pracownicy nie muszą już marnować czasu na przepisywanie danych z tabeli do tabeli,
- brak ludzkich pomyłek – automatyczny import eliminuje błędy literowe, pominięcia czy złe przypisania,
- szybsze decyzje – zawsze masz pod ręką świeże analizy, więc reagujesz na zmiany rynkowe niemal natychmiast,
- jedno źródło prawdy – wszystkie zespoły w Twojej firmie patrzą na te same, spójne i sprawdzone dane.
Dzięki temu możesz skupić się na strategii i rozwoju firmy. Sprawna inżynieria danych pozwoli Ci bezpiecznie skalować biznes bez ciągłego zatrudniania nowych osób do administracji.
Jak przygotowanie danych do uczenia maszynowego pokazuje rolę ETL w projektach AI?
Kiedy przygotowujesz dane do uczenia maszynowego, decydujesz o tym, jak dokładne będą prognozy sztucznej inteligencji. Nawet najlepsze algorytmy nie poradzą sobie z chaotycznymi, zaszumionymi czy niekompletnymi bazami. Proces integracji czyści surowy materiał, ujednolica cechy obiektów i dzieli informacje na zbiory treningowe oraz testowe. Dzisiaj te przetworzone rekordy coraz częściej trafiają do specjalnych baz wektorowych, z których korzystają duże modele językowe (LLM).
Bez dobrze zaprojektowanego potoku danych algorytmy sztucznej inteligencji uczą się błędnych wzorców. Prowadzi to do sytuacji, którą w branży nazywamy „śmieć na wejściu, śmieć na wyjściu”. Powodzenie każdego projektu AI zależy od dokładnego i systematycznego uporządkowania informacji.
Jak filozofia data-centric AI zmienia podejście do integracji danych?
Podejście określane jako data-centric AI stawia jakość i spójność danych wyżej niż sam kod modelu. Przez lata inżynierowie skupiali się głównie na poprawianiu matematycznej architektury sieci neuronowych. Ruch data-centric AI odwraca to myślenie: pokazuje, że musimy stale ulepszać same zestawy uczące. Propagatorem tej zmiany jest Andrew Ng, znany naukowiec, który głośno mówi o konieczności dbania o czystość informacji wprowadzanych do systemów.
Ulepszanie samego kodu matematycznego rzadko daje tak dobre wyniki biznesowe, jak konsekwentna, codzienna praca nad spójnością i czystością danych treningowych.
Liczby mówią same za siebie. Przygotowanie danych zabiera mnóstwo czasu. Z raportu Anaconda 2020 State of Data Science Report wynika, że specjaliści poświęcają średnio aż 45% czasu pracy na samo pozyskanie i oczyszczenie informacji. Nowsza edycja, czyli State of Data Science 2022 Report, wskazuje na 37,75%. Jeśli spojrzymy na klasyczne, duże projekty budowy firmowej hurtowni danych, faza integracji pochłonie nawet do 70% całego budżetu.
ETL vs ELT – czym się różnią i jak technologia chmurowa zmienia reguły gry?
Główna różnica między ETL a ELT tkwi w kolejności kroków i miejscu, w którym przetwarzamy informacje. W klasycznym modelu najpierw zmieniasz format danych na zewnętrznym serwerze, a dopiero potem zapisujesz je v docelowej bazie. Nowe podejście ELT odwraca ten proces: najpierw ładujesz surowe pakiety bezpośrednio do chmury, a dopiero tam system przekształca je, korzystając z mocy obliczeniowej platformy docelowej. To, którą ścieżkę wybierzesz, zależy od skali Twojego biznesu, rodzaju danych oraz budżetu na infrastrukturę.
Przygotowałem tabelę, która pomoże Ci szybko porównać oba te rozwiązania:
| Cecha | Podejście ETL | Podejście ELT |
|---|---|---|
| Kolejność kroków | wyodrębnienie – transformacja – ładowanie | wyodrębnienie – ładowanie – transformacja |
| Miejsce przetwarzania | zewnętrzny serwer (obszar przejściowy) | docelowa baza lub chmurowe repozytorium |
| Rodzaj danych | głównie uporządkowane (relacyjne) | uporządkowane, częściowo uporządkowane i nieuporządkowane |
| Skalowalność | zależy od parametrów Twojego serwera | elastyczna dzięki zasobom chmurowym |
| Koszty na start | wyższe opłaty za specjalne narzędzia | płacisz za realne zużycie mocy w chmurze |
Podejście ELT sprawdzi się świetnie, jeśli przetwarzasz ogromne zbiory Big Data oraz pliki nieuporządkowane, np. wideo czy nagrania dźwiękowe. Z kolei klasyczne potoki integracyjne wciąż dominują w branżach o surowych regulacjach prawnych – na przykład w finansach i medycynie. Wybór zależy od tego, czego dokładnie potrzebuje Twój biznes.
Jaka przyszłość czeka integrację danych w firmach?
Automatyczne przepływy danych tworzą stabilną strukturę analityczną opartą na faktach. AI rozwija się błyskawicznie, dlatego czyste i uporządkowane bazy będą coraz ważniejsze. Jeśli Twoja firma zignoruje ten krok, szybko przegra walkę o rynek z konkurentami, którzy już teraz stawiają na technologię. Czas porzucić ręczne analizy i przenieść się na automatyczne rurociągi danych.
Proponuję zaplanować wdrożenie nowej architektury danych według prostego schematu:
- audyt posiadanych zasobów – dokładnie sprawdź wszystkie źródła informacji w swojej firmie,
- uruchomienie potoków danych – zaprojektuj i wdróż stabilne połączenia między CRM, ERP a aplikacjami w chmurze,
- pomoc specjalistów – skonsultuj się z doświadczonymi inżynierami, żeby obniżyć koszty utrzymania systemów i uniknąć błędów projektowych.
Napisz do nas lub zadzwoń. Chętnie pomożemy Ci przeanalizować i usprawnić przepływ informacji w Twojej firmie. Stwórzmy razem stabilny fundament pod nowoczesny biznes gotowy na wyzwania ery sztucznej inteligencji.
FAQ – najczęściej zadawane pytania o ETL
Zebrałem odpowiedzi na najczęstsze pytania o integrację danych. Te krótkie wyjaśnienia pomogą Ci zrozumieć, jak te procesy ułatwią codzienną pracę w Twojej firmie.
Co dokładnie oznacza skrót ETL?
To skrót od angielskich słów Extract, Transform, Load, czyli: wyodrębnianie, przekształcanie i ładowanie danych. Chodzi o pobranie surowych informacji z różnych, często niepasujących do siebie miejsc, a potem ich ujednolicanie. Następnie system oczyszcza te dane i zapisuje w nowej bazie, dzięki czemu możesz je bez przeszkód analizować.
Czym różni się ETL od ELT?
Chodzi głównie o to, gdzie i kiedy zmieniasz format danych. W tradycyjnym podejściu modyfikujesz informacje na zewnętrznym serwerze, zanim wyślesz je do bazy docelowej. W przypadku ELT najpierw zapisujesz surowe rekordy w chmurze, a potem zmieniasz ich postać, korzystając z chmurowej mocy obliczeniowej.
Ile czasu specjaliści poświęcają na przygotowanie danych?
Inżynierowie danych spędzają od 37% do 45% swojego czasu na samym czyszczeniu baz. Takie wnioski płyną z raportów firmy Anaconda – porządkowanie informacji to najbardziej czasochłonne zadanie. Projektowanie i budowa hurtowni danych potrafi z kolei pochłonąć nawet do 70% całego budżetu przeznaczonego na ten cel.
Dlaczego przygotowanie danych jest tak ważne dla rozwoju AI?
Dzięki temu usuwasz błędy, braki i niespójności z baz, których używasz do szkolenia sztucznej inteligencji. Jeśli nie zadbasz o sprawną integrację, algorytmy nauczą się złych schematów. Przez to Twoje modele AI będą podawać błędne prognozy, a to może narazić Cię na poważne straty finansowe.


Poszukujesz agencji SEO w celu wypozycjonowania swojego serwisu? Skontaktujmy się!

Paweł Cengiel
Cechuję się holistycznym podejściem do SEO, tworzę i wdrażam kompleksowe strategie, które odpowiadają na konkretne potrzeby biznesowe. W pracy stawiam na SEO oparte na danych (Data-Driven SEO), jakość i odpowiedzialność. Największą satysfakcję daje mi dobrze wykonane zadanie i widoczny postęp – to jest mój „drive”.
Wykorzystuję narzędzia oparte na sztucznej inteligencji w procesie analizy, planowania i optymalizacji działań SEO. Z każdym dniem AI wspiera mnie w coraz większej liczbie wykonywanych czynności i tym samym zwiększa moją skuteczność.